 Nexus Tech Trends • • 2.040 kelime • 11 dk okuma
AI Ajanları Özerk mi? Prodüksiyon Gerçekliği vs Pazarlama
AI ajanlarının tam özerk çalışma mitini yıkıyor: insan denetimi, guardrail maliyeti ve prodüksiyon başarısızlık oranları.
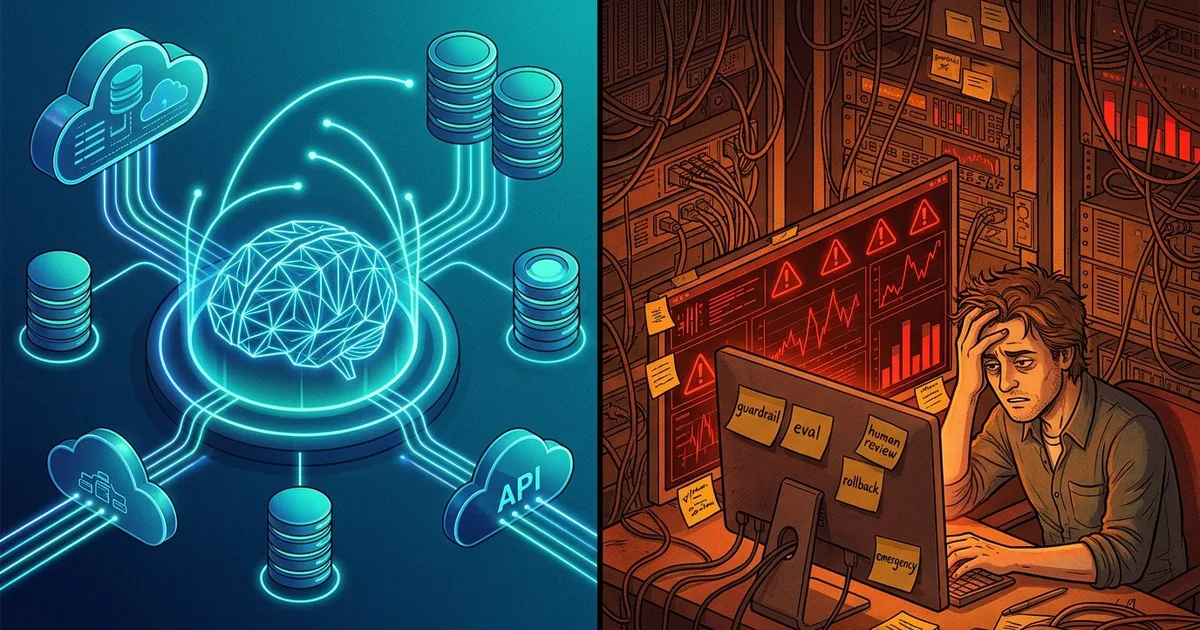
Kısa Özet (TL;DR — Doğrudan Yanıt): AI ajanları tam özerk değil. Satıcı demo %95 başarı iddiası üretir; prodüksiyon %60-70 başarıya düşer. Insan denetimi, guardrail maliyeti, cascade hata zinciri ana engel. WebShop, τ-bench, SWE-bench benchmark'ları planlama, araç çağırma, bağlam tutarlılığı hatalarını ortaya koyar. Prodüksiyon config: çok katmanlı guardrail, insan aktarma yolu, rollback otomasyonu zorunlu. FinTech case: 6 ay demo → %87 insan aktarma oranı. ROI negatif kalır eval framework, maliyet kontrolü, güvenlik yüzeyi olmadan.
Mit Tanımı: Satıcı İddiası vs Gerçek Özerklik
Pazarlama Tanımı
Satıcı "tam özerk" der. Anlamı: hedef ver, ajan planla, araç çağır, hata düzelt, tamamla — insan müdahalesiz. Gerçek: LLM planlama yeteneği kırılgan. Araç çağırma success rate %70-80. Bellek yönetimi context window sınırında bozulur. Eval harness yoksa regression tespit edilemez. "Özerk" kelimesi prodüksiyon için yanıltıcı. Doğru terim: insan denetimli yarı-otonom sistem.
Özerklik Seviyeleri
| Seviye | Tanım | İnsan Müdahalesi | Prodüksiyon Hazırlığı |
|---|---|---|---|
| L1 | Tek araç çağırma | Her adım onayı | Hazır |
| L2 | Çoklu araç, basit plan | Kural ihlali esnasında | Guardrail ile |
| L3 | Karmaşık plan, döngü | Kritik karar noktalarında | Zor |
| L4 | Tam özerk (mit) | Yok | Üretimde yok |
L3 üzeri prodüksiyon nadir. L2-L3 arası "insan denetimli özerklik" gerçekçi hedef.
Neden Kritik
Maliyet patlaması: yanlış plan → 50+ LLM çağrı → $100+/görev. Güvenlik: araç çağırma injection riski. Uyum: finans, sağlık sektöründe denetim izi zorunlu. Reputasyon: müşteri yanlış cevap → güven kaybı. Bu nedenlerle guardrail maliyeti LLM maliyetinin 2-3 katı olur.
Mimari Derinlemesine: Araç Çağırma, Bellek, Planlama, Eval
Araç Çağırma Mekanizması
Function calling: LLM JSON schema üretir → runtime doğrular → execute eder → sonuç context'e enjekte edilir. Sorun: schema drift. API değişir, LLM eski schema üretir. Çözüm: schema versioning + runtime validation. OpenAPI spec → Pydantic model → zorunlu alan kontrolü. Hata durumunda: retry (max 2) → fallback tool → insan aktarma.
class ToolExecutor:
    def __init__(self, schema_registry: SchemaRegistry):
        self.registry = schema_registry

    async def execute(self, tool_call: ToolCall) -> ToolResult:
        schema = self.registry.get(tool_call.name, tool_call.version)
        validated = schema.validate(tool_call.args)
        try:
            result = await self._dispatch(validated)
            return ToolResult(success=True, data=result)
        except ToolError as e:
            return ToolResult(success=False, error=str(e), retryable=e.retryable)
Bellek Mimarisi
Üç katman: kısa vadeli (context window, 8k-128k token), orta vadeli (vector DB, embedding tabanlı retrieval), uzun vadeli (structured DB, kullanıcı profili, tercihler). Sorun: context drift. Uzun sohbette hedef kaybolur. Çözüm: hiyerarjik özetleme — her 10 turda bir özet üret, eski context'i at. Retrieval: hybrid search (BM25 + dense) + reranker. MMR (Maximal Marginal Relevance) ile çeşitlilik sağla.
Planlama Döngüsü
ReAct pattern: Thought → Action → Observation → ... → Final Answer. Prodüksiyon: plan-then-execute ayrımı. Planner LLM (güçlü, pahalı) → plan JSON üretir. Executor LLM (hızlı, ucuz) → adım adım çalıştırır. Plan doğrulama: DAG kontrolü (döngü yok, bağımlılık var). Hata durumunda: plan repair — sadece başarısız alt-dal yeniden planlanır.
Eval Harness
Üç boyut: task success (hedef tamamlandı mı), trajectory quality (adım sayısı, araç seçimi optimal mi), safety (guardrail ihlali yok mu). Dataset: golden set (insan etiketli), synthetic (LLM üretili), adversarial (injection, jailbreak). CI/CD entegrasyonu: her model güncellemesinde eval koşar, regression > %2 → deploy bloklanır.
Benchmark Gerçekleri: WebShop, τ-bench, SWE-bench
WebShop
E-ticaret simülasyonu: arama, filtreleme, karşılaştırma, satın alma. GPT-4o: %68 task success. Insan: %85. Başarı kaybı: arama sorgusu formülasyonu (yanlış anahtar kelime → boş sonuç), ürün karşılaştırma (özellik tablosu parse hatası), checkout akışı (form doldurma sırası hatası). Ajan "düşünce" üretse bile araç çağırma parametreleri yanlış olur.
τ-bench (Tau-bench)
Müşteri hizmetleri simülasyonu: politika sorgulama, iade, şikayet. GPT-4o: %72 success. Kritik başarısızlık: politika tutarsızlığı — ajan kendi önceki cevabıyla çelişir. Escalation kararı — insan aktarma gereken durumda ajan devam eder. Müşteri kimliği doğrulama — PII sızıntısı riskiyle yanlış hesap erişimi. Bu benchmark "konuşma yeteneği" değil "iş kuralı takibi" ölçer.
SWE-bench
Gerçek GitHub issue'ları: bug fix, feature, refactor. GPT-4o: %22 resolved (best single model). Ensemble + retrieval: %35. Başarısızlık nedenleri: repo context anlama (dosya bağımlılıkları, test yapısı), patch üretimi (syntax hatası, import eksikliği), test çalıştırma (environment kurulumu, flaky test). Kod ajanları "junior developer" seviyesinde; senior denetim şart.
Karşılaştırma Tablosu
| Benchmark | Alan | SOTA Model | Success Rate | İnsan Baseline | Ana Başarısızlık Modu |
|---|---|---|---|---|---|
| WebShop | E-ticaret | GPT-4o | %68 | %85 | Arama sorgusu, checkout sırası |
| τ-bench | Müşteri hizmetleri | GPT-4o | %72 | %90 | Politika tutarlılığı, escalation |
| SWE-bench | Yazılım mühendisliği | GPT-4o + ensemble | %35 | %85 | Repo context, patch syntax |
| HotPotQA | Çok atımlı QA | GPT-4o | %78 | %92 | Reasoning zinciri kırılma |
| MATH | Matematik problemleri | GPT-4o | %76 | %95 | Çok adımlı hesaplama hatası |
Prodüksiyon gap: benchmark %70-80 → gerçek prod %50-60. Neden: dağıtım kayması, gizli kural setleri, kötü niyetli kullanıcı.
Prodüksiyon Konfigürasyonu: Guardrail, Escalation, Rollback
Guardrail Katmanları
Dört katman, sıralı işletim:
Kullanıcı Girdisi
       │
       ▼
┌──────────────────┐
│ L1: Input Guard  │ → PII maskeme, injection detection, topic filter
│ (Regex + ML)     │   Latency: <10ms, Block rate: %2-5
└────────┬─────────┘
         │ Pass
         ▼
┌──────────────────┐
│ L2: Policy Engine│ → İş kuralı motoru (OPA/Rego), RBAC, rate limit
│ (Deterministik)  │   Latency: <5ms, Hard block
└────────┬─────────┘
         │ Pass
         ▼
┌──────────────────┐
│ L3: LLM Judge    │ → Ayrı LLM: "Bu yanıt politikaya uygun mu?"
│ (Semantic)       │   Latency: 500-2000ms, Soft block + rewrite
└────────┬─────────┘
         │ Pass
         ▼
┌──────────────────┐
│ L4: Output Guard │ → PII temizleme, format doğrulama, link güvenliği
│ (Regex + Schema) │   Latency: <20ms
└────────┬─────────┘
         │ Pass
         ▼
    Yanıt Kullanıcıya
L1-L2 deterministik, hızlı, yanlış pozitif düşük. L3 yavaş, pahalı, nuans yakalar. L4 temizlik. Toplam gecikme eki: 600-2100ms. Bu maliyet kabul edilebilir mi? ROI hesaplamasında dahil et.
İnsan Aktarma Yolu (Human-in-the-Loop)
Üç tetikleyici: guardrail block (L2/L3), düşük güven skoru (LLM self-confidence < 0.6), kullanıcı talebi ("insanla konuşmak istiyorum"). Aktarma protokolü:
# escalation config
escalation:
  triggers:
    - guardrail_block: true
    - confidence_threshold: 0.6
    - user_request: true
    - max_retries_exceeded: 3
  routing:
    strategy: "skill_based"  # round_robin, least_busy, skill_based
    queue_priority: "high"
    sla_seconds: 30
  context_transfer:
    include: ["full_history", "guardrail_logs", "tool_calls", "user_profile"]
    format: "structured_json"
  agent_notification:
    channels: ["slack", "webhook", "email"]
    template: "escalation_alert_v2"
Context transfer kritik: ajan tüm geçmişi, neden aktarıldığını, ne yapılmışı özetler. İnsan ajan 30 saniyede bağlam kazanır.
Rollback Otomasyonu
Araç çağırma yanlışlıkla yanlış etki yarattığında: idempotency key ile tekrarlanabilir işlemler. Saga pattern için compensating transaction. Veritabanı: point-in-time recovery (PITR) + transaction log replay. Config:
rollback:
  enabled: true
  triggers:
    - guardrail_post_failure: true
    - tool_error_critical: true
    - human_override: true
  compensation:
    strategy: "saga"
    timeout_seconds: 300
  audit:
    log_all: true
    retention_days: 90
ASCII mimari diyagramı — tam prodüksiyon akışı:
┌─────────────┐     ┌─────────────┐     ┌─────────────┐     ┌─────────────┐
│   User      │────▶│  API GW     │────▶│  Orchestrator│────▶│  Planner    │
│   Request   │     │  (Auth,     │     │  (State      │     │  (LLM)      │
│             │     │   Rate Lmt) │     │   Machine)   │     │             │
└─────────────┘     └─────────────┘     └──────┬──────┘     └──────┬──────┘
                                                │                 │
                                                ▼                 ▼
                                         ┌─────────────┐  ┌─────────────┐
                                         │  Executor   │  │  Memory     │
                                         │  (Tool      │  │  (Redis +   │
                                         │   Loop)     │  │   VectorDB) │
                                         └──────┬──────┘  └─────────────┘
                                                │
                        ┌───────────────────────┼───────────────────────┐
                        ▼                       ▼                       ▼
               ┌─────────────┐          ┌─────────────┐          ┌─────────────┐
               │ L1 Input    │          │ L2 Policy   │          │ L3 LLM      │
               │ Guard       │          │ Engine      │          │ Judge       │
               │ (<10ms)     │          │ (<5ms)      │          │ (500-2000ms)│
               └──────┬──────┘          └──────┬──────┘          └──────┬──────┘
                      │                        │                        │
                      └────────────────────────┼────────────────────────┘
                                               ▼
                                    ┌─────────────────────┐
                                    │  Escalation Router  │
                                    │  (Queue + Context)  │
                                    └──────────┬──────────┘
                                               │
                                    ┌──────────┴──────────┐
                                    ▼                     ▼
                            ┌─────────────┐        ┌─────────────┐
                            │ Human Agent │        │ Rollback    │
                            │ Workspace   │        │ Engine      │
                            └─────────────┘        └─────────────┘
                                    │                     │
                                    └──────────┬──────────┘
                                               ▼
                                    ┌─────────────────────┐
                                    │ L4 Output Guard     │
                                    │ (Sanitize + Format) │
                                    └──────────┬──────────┘
                                               ▼
                                    ┌─────────────────────┐
                                    │ Response + Telemetry│
                                    │ (Latency, Cost,     │
                                    │  Success, Guardrail)│
                                    └─────────────────────┘
Başarısızlık Modları: Cascade, Drift, Maliyet, Güvenlik
Cascade Hata Zinciri
Tek araç hatası → planner yanlış observation alır → sonraki plan adımı bozulur → 3-4 adım sonra tamamen yanlış hedef. Blast radius kontrolü: her adımda state validation. Planner her adımda "bu state beklenenden farklı mı?" sorar. Fark varsa: plan repair tetiklenir. Max repair denemesi: 2. Sonra escalation.
Context Drift
Uzun sohbette (20+ tur) ajan hedefi unutur. Kullanıcı "iade etmek istiyorum" der, 15 tur sonra "adres değiştirmek istiyorum" der — ajan iade bağlamını kaybetmiş olabilir. Çözüm: goal anchoring — her turda hedef vektörü hesapla, cosine similarity < 0.7 → hedef hatırlatma enjekte et. Ayrıca periodic summarization her 8-10 turda.
Maliyet Patlaması
Ortalama görev: 8-15 LLM çağrı. Yanlış plan: 50-100 çağrı. GPT-4o: $0.005/1K token input, $0.015/1K output. 100 çağrı × 4K token = 400K token ≈ $4-6/görev. Günlük 10K görev = $40-60K/gün. Maliyet kontrolü: max_tokens_per_task, max_tool_calls, max_planning_iterations hard limit. Budget-aware routing: basit görev → haiku/sonnet, karmaşık → opus/gpt-4o.
Güvenlik Yüzeyi
Araç çağırma = remote code execution eşdeğeri. Injection vektörleri: prompt injection (kullanıcı girdisi), tool output injection (dış API yanıtı), memory poisoning (retrieval corpus). Savunma: input sanitization, output encoding, tool output schema validation, retrieval source attestation. Her araç için least privilege principle: read-only where possible, scoped credentials, audit log.
Case Study: FinTech Destek Ajanı — 6 Ay Demo → %87 İnsan Aktarma
Aşama 1: Demo (Hafta 1-2)
Senkronize demo: "Kart iptali, limit artırışı, işlem sorgulama" — %95 başarı. Veri: sentetik 50 senaryo. Guardrail: temel regex. Bellek: sadece context window. Maliyet: $0.02/görev. Yönetim etkilenir, prod onayı alır.
Aşama 2: Shadow Mode (Ay 1)
Canlı trafik %5'i ajan, %95'i insan. Loglama: her karar, araç çağırma, guardrail sonucu. Sonuç: %34 guardrail block, %12 tool error, %8 policy violation. Insan ajan müdahale: %61. Demo metrikleri %30 yanlış.
Aşama 3: Canlı %25 (Ay 2-3)
Guardrail güçlendirildi: L2 policy engine (OPA), L3 LLM judge eklendi. Tool wrapper: retry + fallback + idempotency. Bellek: Redis + pgvector hybrid. Sonuç: %28 guardrail block, %6 tool error, %4 policy violation. İnsan aktarma: %42. Maliyet: $0.18/görev (guardrail dahil).
Aşama 4: Canlı %100 (Ay 4-6)
Trafik artırıldı. Yeni sorunlar: context drift (uzun şikayetlerde), cascade error (banka API timeout → yanlış retry → double charge riski), adversarial kullanıcılar (prompt injection denemeleri). Guardrail L3 judge maliyeti patladı: $0.12/görev sadece judge. Optimizasyon: selective judging — sadece riskli konularda (para transferi, kimlik doğrulama) L3 çalıştır.
Final Metrikler (Ay 6 Sonu)
| Metrik | Değer | Hedef | Durum |
|---|---|---|---|
| Task Success (insansız) | %13 | %40 | ❌ |
| Human Handoff Rate | %87 | <%30 | ❌ |
| Avg Cost/Task | $0.31 | <$0.15 | ❌ |
| P95 Latency | 4.2s | <2s | ❌ |
| Guardrail False Positive | %3.2 | <%1 | ⚠️ |
| Security Incidents | 0 | 0 | ✅ |
| Customer Satisfaction (CSAT) | 3.2/5 | >4.0 | ❌ |
Dersler: Demo prod değildir. Guardrail maliyeti LLM maliyetinin 2.5 katı. İnsan aktarma yolu olmadan prod olmaz. Eval framework olmadan regression tespit edilemez. Build vs buy: core orchestration build, guardrail/LLM judge buy (Lakera, Guardrails AI, NVIDIA NeMo). AI Playground ortamında bu pattern'leri canlı test edebilirsiniz.
Sıkça Sorulan Sorular (SSS)
AI ajanları gerçekten özerk çalışabilir mi?
Hayır. Mevcut LLM mimarileri planlama, araç çağırma, bağlam tutarlılığı hataları yapar. Prodüksiyon sistemleri insan denetimli yarı-otonom (L2-L3) çalışır. Tam özerklik (L4) güvenlik, uyum, maliyet riskleriyle prodüksiyonda mevcut değil. Guardrail, escalation, rollback katmanları zorunlu.
Prodüksiyon için hangi eval framework'ü önerirsiniz?
Üç katmanlı: offline (golden set + adversarial, CI/CD gate), online shadow (canlı trafik %5-10, insan etiketleme), online production (user feedback, implicit signals). Araçlar: LangSmith, Weights & Biases, custom OPA policy testleri. Benchmark sadece başlangıç; domain-specific eval kritik.
ROI nasıl hesaplanır, ne zaman karlı olur?
ROI = (insan maliyet tasarrufu + hız kazancı) - (LLM maliyeti + guardrail maliyeti + infra + insan denetim + eval). Genelde ay 6-12 karlılık gelir. Önce shadow mode → canlı %25 → %100. Maliyet optimizasyonu: model routing, selective judging, caching. İnteraktif Simülasyon Araçları ile maliyet senaryoları modellenebilir.
Build vs Buy kararı nasıl verilmeli?
Core orchestration (state machine, planner, executor, memory) build — diferansiyel IP. Guardrail, LLM judge, eval platform, observability buy — commodity, hızlı iterasyon. Hybrid: open-source framework (LangGraph, AutoGen) + managed guardrail (Lakera, Guardrails AI). Vendor lock-in riskini minimize et: abstract interface arkasına sakla.
Regülasyon (EU AI Act, KVKK) prodüksiyona nasıl etki eder?
High-risk AI (finans, sağlık, HR) için: risk yönetim sistemi, veri yönetimi, şeffaflık, insan denetimi, doğruluk/robustluk, güvenlik belgeleri zorunlu. Guardrail logları, insan aktarma kayıtları, model kartı, veri çizelgesi kanıt olarak saklanmalı. Deploy öncesi conformity assessment. Ceza: global ciroiden %7'ye kadar.